


NESTOR — Neurosyphilis: Extraction via Scanned Texts and OCR for medical Research
Idioma de origem: Inglês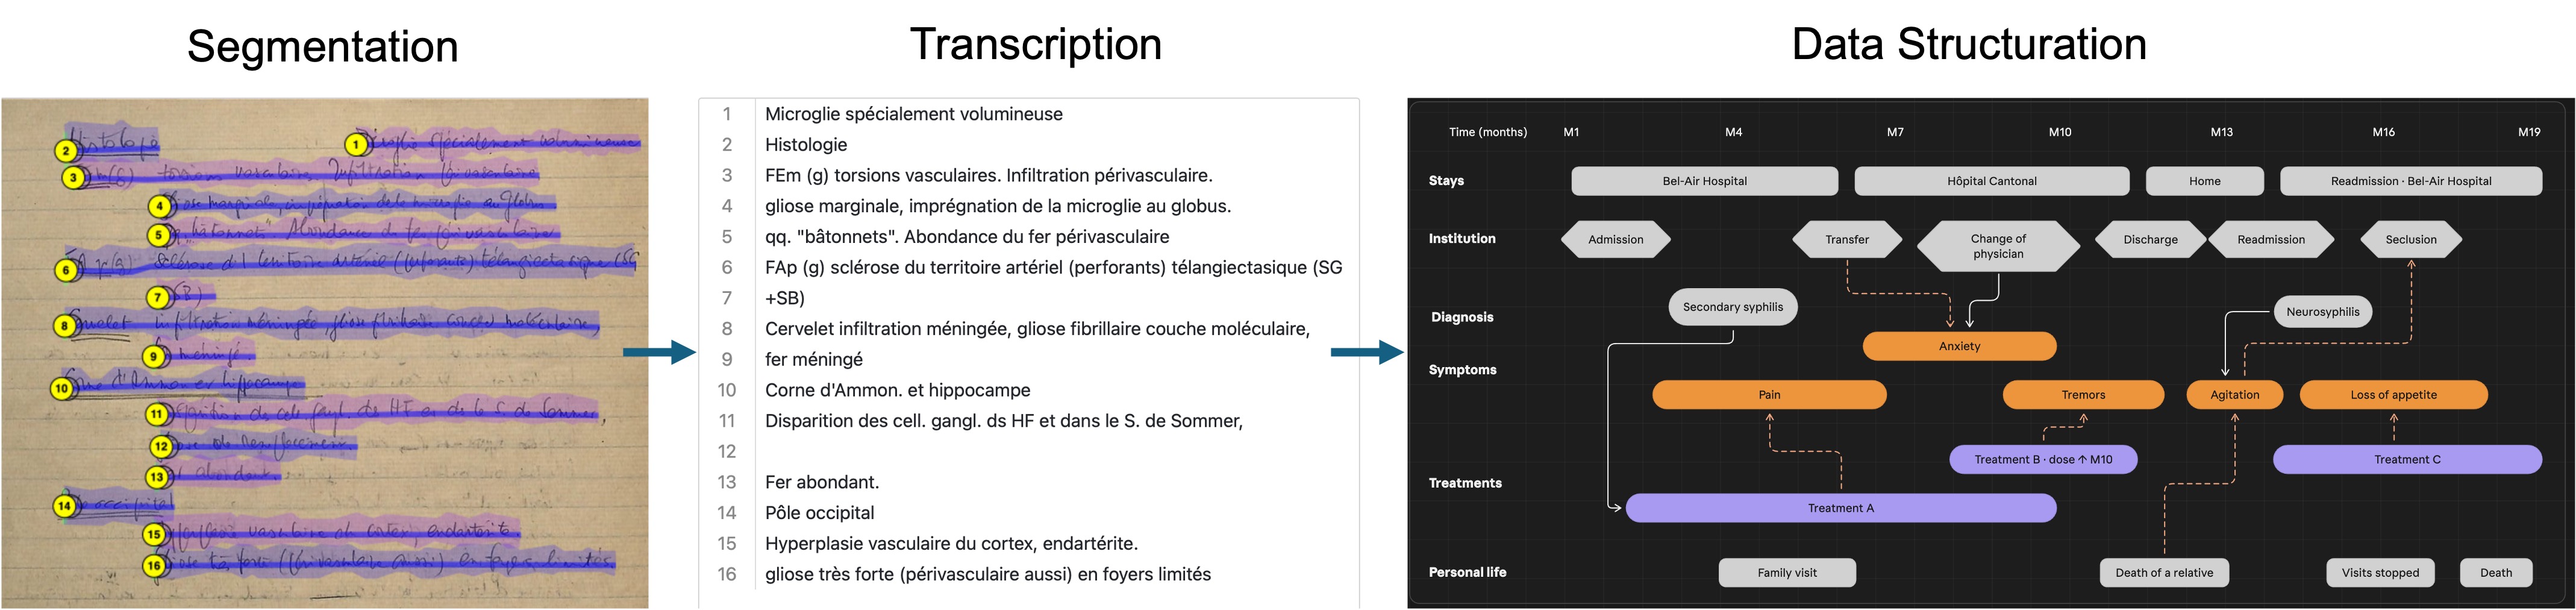
NESTOR (Neurosífilis: Extração através de textos digitalizados e OCR para investigação médica) é um projeto interdisciplinar da Universidade de Genebra e dos hospitais universitários de Genebra que permite o acesso a arquivos médicos manuscritos para fins de investigação.
O problema: os hospitais, arquivos e biobancos conservam vastas coleções de processos de pacientes escritos à mão, registos e inventários que documentam décadas de prática clínica. Estes registos constituem uma fonte única sobre a prática clínica histórica, mas continuam em grande parte inacessíveis: a transcrição manual é lenta e dispendiosa, e o Reconhecimento Ótico de Caracteres(OCR) tem um desempenhomal com a caligrafia manual, e as regras de confidencialidade dos pacientes excluem a maioria das ferramentas comerciais na nuvem.
A abordagem: o NESTOR adapta métodos de reconhecimento de texto manuscrito das humanidades digitais, um domínio com experiência na transcrição de manuscritos históricos. Um modelo base treinado com mais de 20 000 páginas que abrangem cinco séculos e cinco línguas foi aperfeiçoado com registos do Geneva Brain Bank, uma coleção fundada em 1901 que contém dados clínicos de mais de 11 000 doentes. Utilizando cerca de 500 páginas transcritas manualmente e escritas em francês entre 1883 e 1980, o modelo aperfeiçoado e adaptado a esses arquivos atinge 87% de precisão. O fluxo de trabalho é totalmente de código aberto, gratuito e funciona offline num portátil padrãoportátil, pelo que é adequado para dados sensíveis.Requer uma anotação específica do domínio mínima e baseia-se em dados de treino não médicos, evitando as barreiras éticas associadas à partilha de manuscritos médicos.Pode, portanto, ser replicado em hospitais e arquivos, e em contextos com recursos limitados, onde ainda hoje são produzidos registos médicos manuscritos.

