


NESTOR — Neurosyphilis: Extraction via Scanned Texts and OCR for medical Research
Langue d'origine: Anglais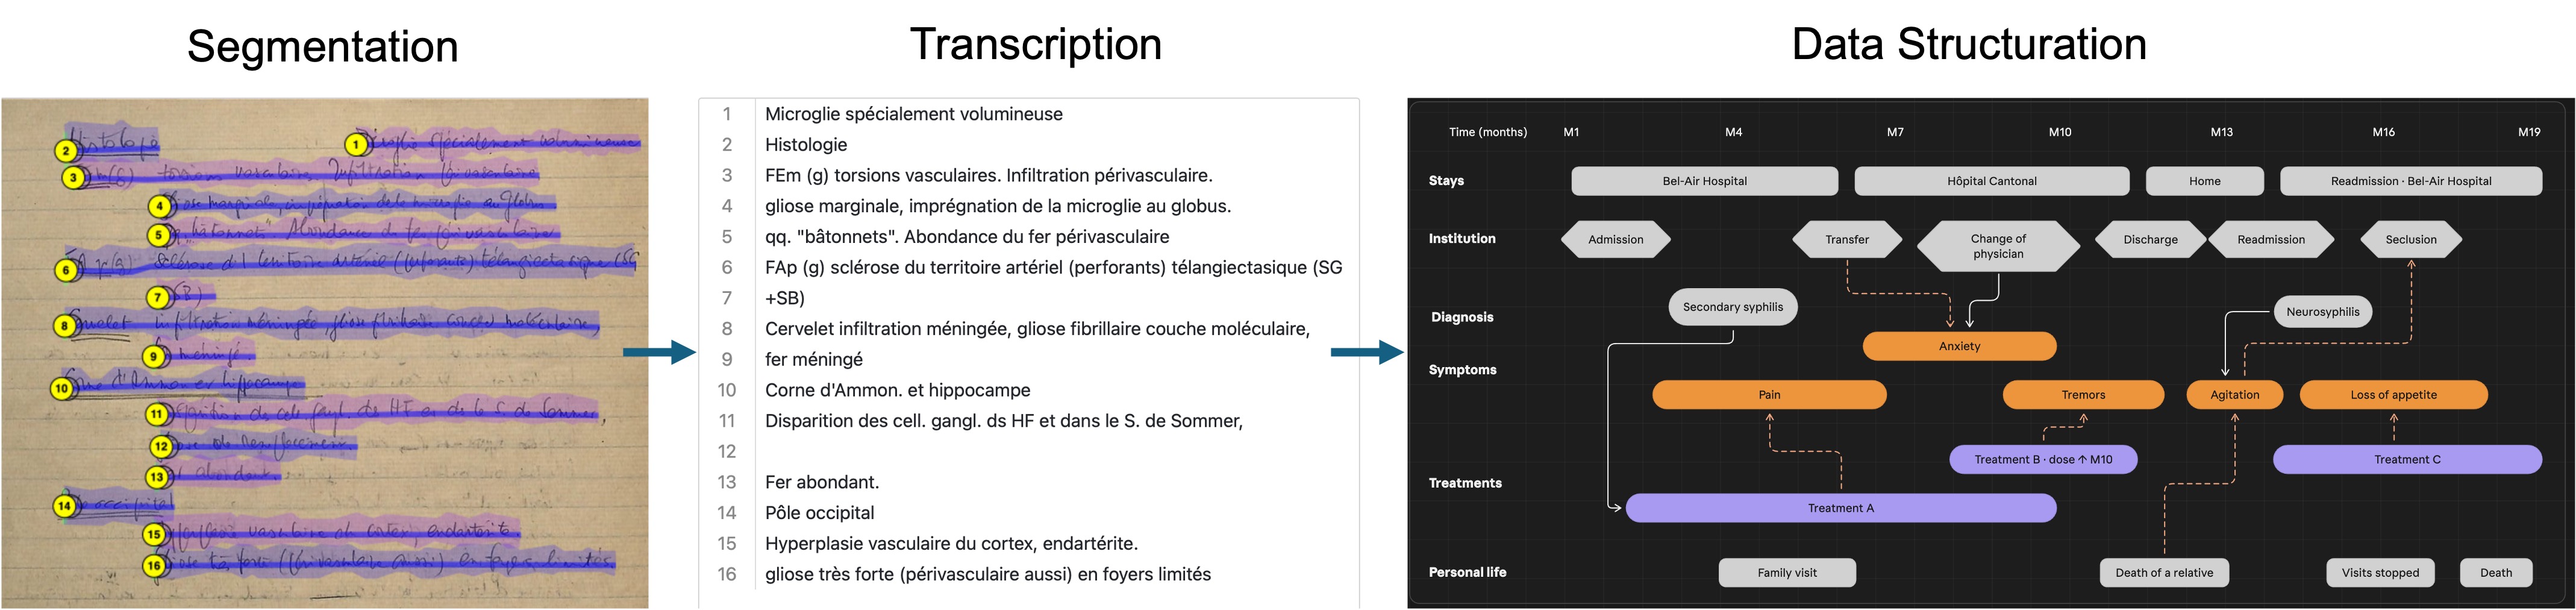
NESTOR (Neurosyphilis : Extraction à partir de textes numérisés et OCR pour la recherche médicale ) est un projet interdisciplinaire de l’Université de Genève et des hôpitaux universitaires de Genève qui rend accessibles les archives médicales manuscrites à des fins de recherche.
Le problème : les hôpitaux, les archives et les biobanques conservent de vastes de dossiers de patients manuscrits, de registres et d’inventaires documentant des décennies de pratique clinique. Ces documents constituent une source unique sur la pratique clinique historique, mais ils restent largement inaccessibles : la transcription manuelle est lente et coûteuse, et la reconnaissance optique de caractères (OCR) conventionnelle fonctionne des résultats médiocres sur l’écriture manuscrite, et les règles de confidentialité des patients excluent la plupart des outils commerciaux basés sur le cloud.
L’ approche : NESTOR adapte les méthodes de reconnaissance du texte manuscrit issues des humanités numériques, un domaine qui possède une grande expérience en matière de transcription de manuscrits historiques. Un modèle de base entraîné sur plus de 20 000 pages couvrant cinq siècles et cinq langues a été affiné à partir des dossiers de la Banque du cerveau de Genève, une collection fondée en 1901 et qui contient des données cliniques sur plus de 11 000 patients. À partir d’environ 500 pages transcrites à la main en français entre 1883 et 1980, le modèle affiné et adapté à ce type d’archives atteint une précision de 87 %. Le pipeline est entièrement open source, gratuit et fonctionne hors ligne sur un ordinateur portable standard , ce qui le rend parfaitement adapté au traitement de données sensibles. Il nécessite un minimum d’annotations spécifiques au domaine et s’appuie sur des données d’entraînement non médicales, ce qui permet d’éviter les obstacles éthiques liés au partage de manuscrits médicaux. Elle peut donc être reproduite dans différents hôpitaux et archives, ainsi que dans milieux aux ressources limitées où des dossiers médicaux manuscrits sont encore rédigés aujourd’hui.

