


NESTOR — Neurosyphilis: Extraction via Scanned Texts and OCR for medical Research
Idioma de origen: Inglés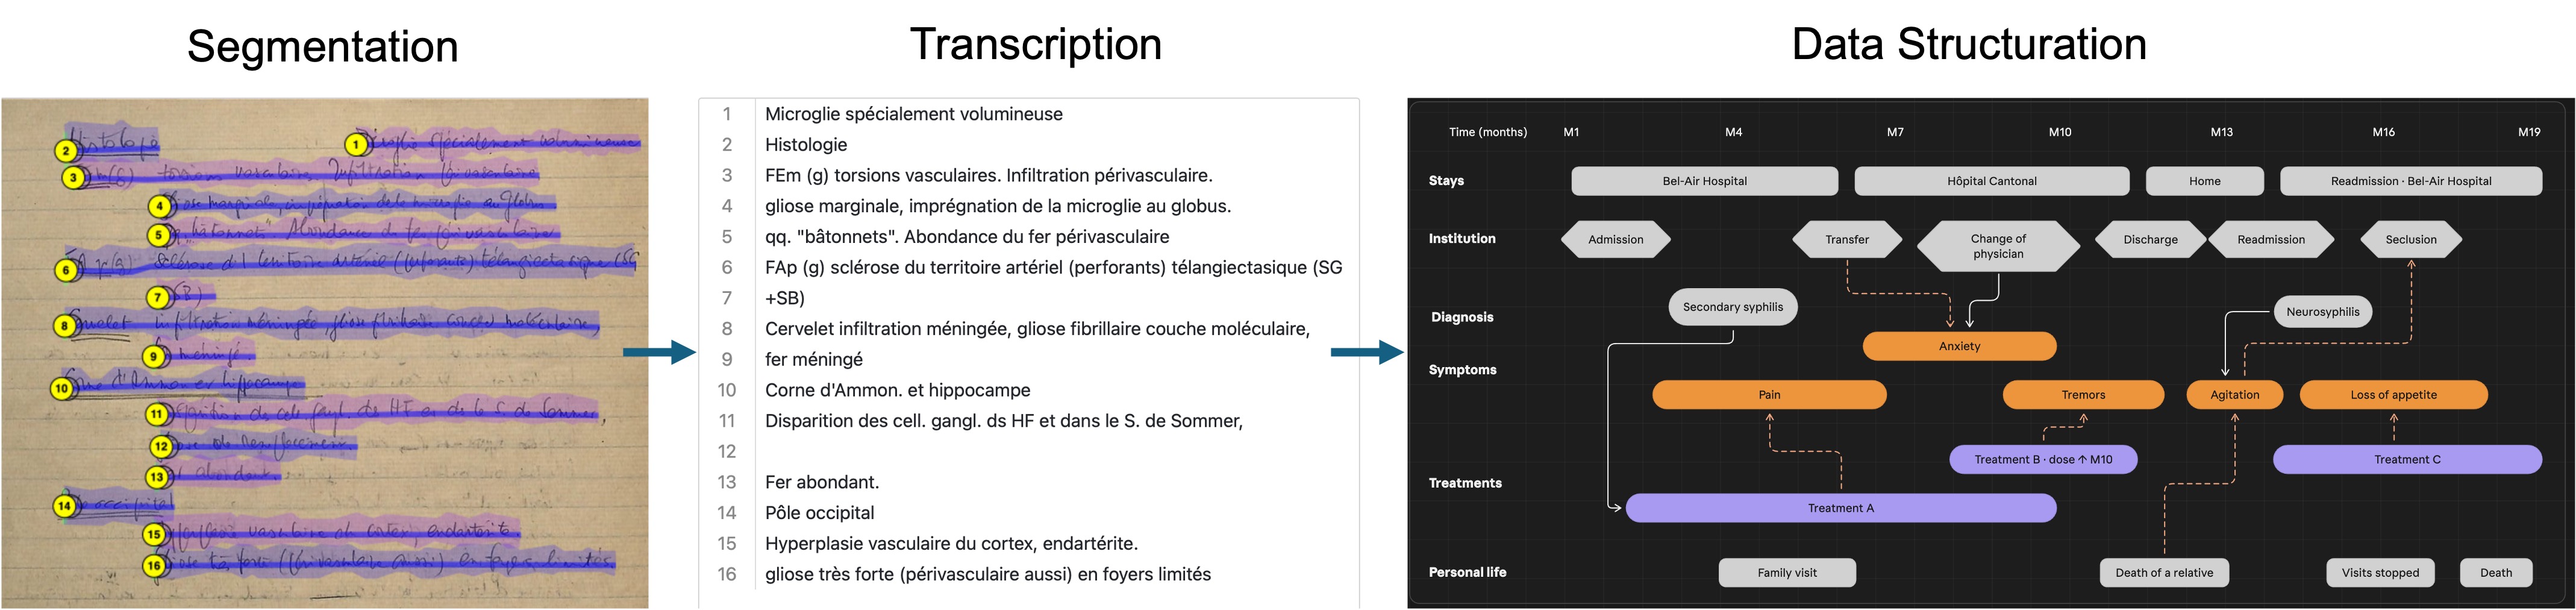
NESTOR (Neurosífilis: Extracción a través de textos escaneados y OCR para la investigación médica ) es un proyecto interdisciplinar de la Universidad de Ginebra y los hospitales universitarios de Ginebra que permite acceder a archivos médicos manuscritos con fines de investigación.
El problema: los hospitales, los archivos y los biobancos conservan vastas colecciones de expedientes de pacientes escritos a mano, registros e inventarios que documentan décadas de práctica clínica. Estos registros constituyen una fuente única sobre la práctica clínica histórica, pero siguen siendo en gran medida inaccesibles: la transcripción manual es lenta y costosa, y el reconocimiento óptico de caracteres convencional(OCR) funciona mal con la escritura manuscrita, y las normas de confidencialidad de los pacientes descartan la mayoría de las herramientas comerciales en la nube.
El enfoque: NESTOR adapta los métodos de reconocimiento de texto manuscrito de las humanidades digitales, un campo con amplia experiencia en la transcripción de manuscritos históricos. Un modelo base entrenado con más de 20 000 páginas que abarcan cinco siglos y cinco idiomas fue perfeccionado con registros del Banco de Cerebros de Ginebra, una colección fundada en 1901 que contiene datos clínicos de más de 11 000 pacientes. Utilizando unas 500 páginas transcritas manualmente y redactadas en francés entre 1883 y 1980, el modelo perfeccionado y adaptado a este tipo de archivos alcanza una precisión del 87 %. El proceso es totalmente de código abierto, gratuito y funciona sin conexión en un portátil estándarportátil estándar, por lo que resulta adecuado para datos confidenciales.Requiere un mínimo de anotaciones específicas del ámbito y se basa en datos de entrenamiento no médicos, lo que evita las barreras éticas que supone compartir manuscritos médicos.Por lo tanto, puede replicarse en diferentes hospitales y archivos, así como en entornos con recursos limitados en los que aún hoy se siguen elaborando historiales médicos manuscritos.

